Cuando hablamos, las palabras no viajan solas. Movemos las manos, asentimos, negamos con la cabeza, cambiamos la expresión del rostro. Para una persona con parálisis, perder el movimiento puede significar perder también buena parte de esa forma de comunicarse.
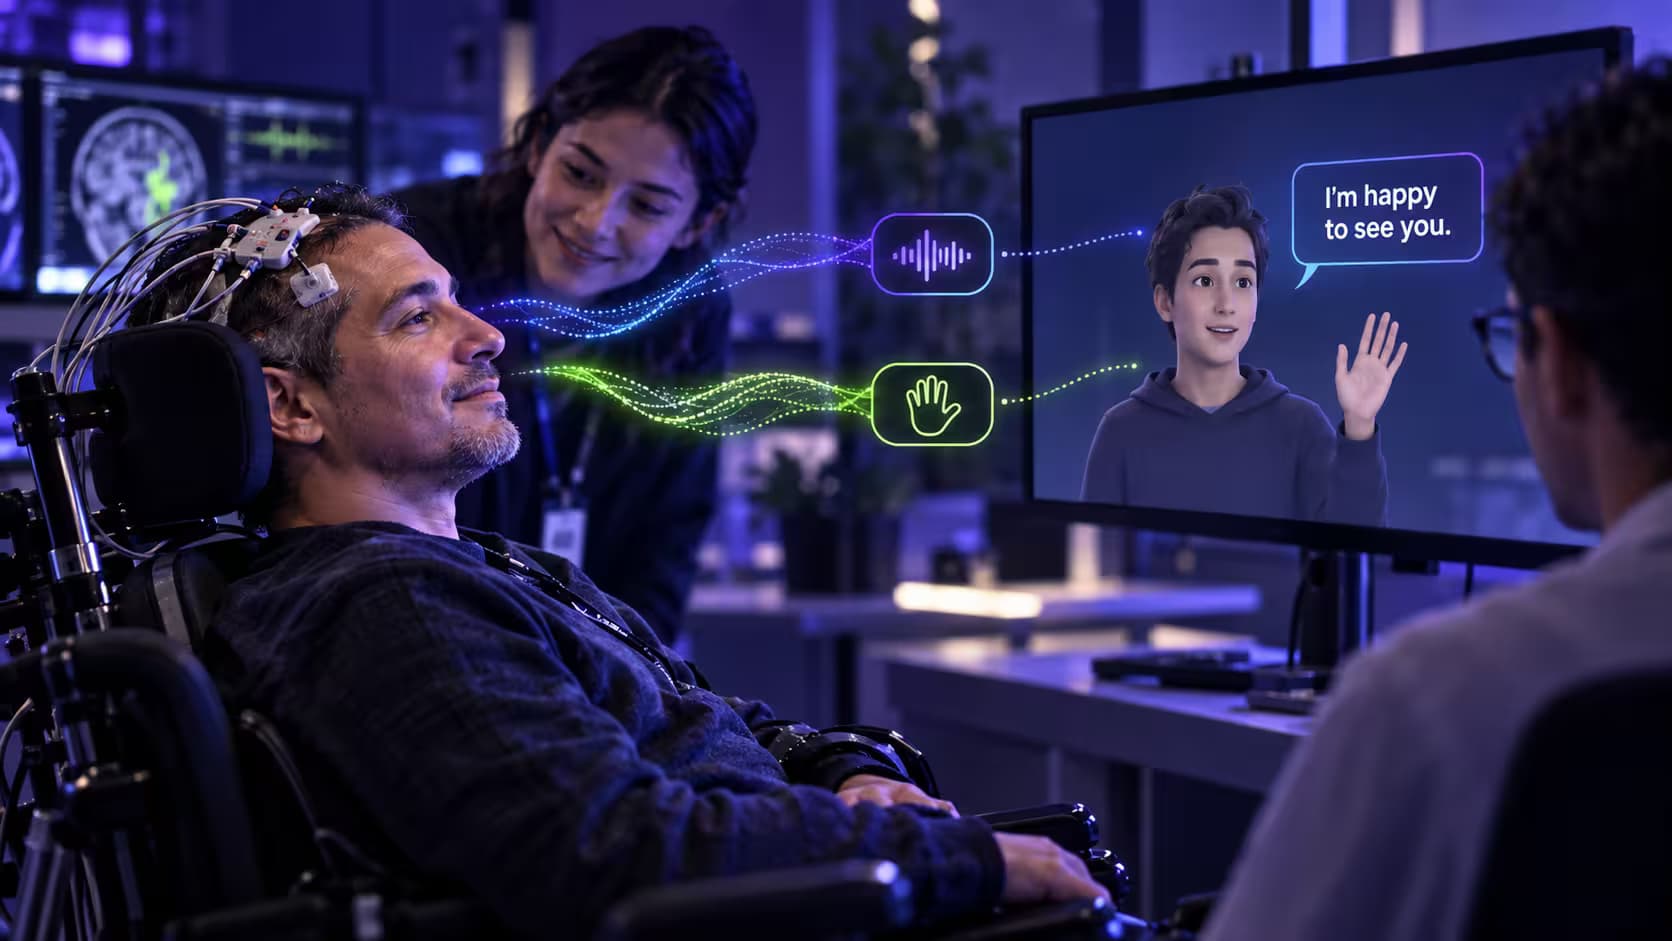
Un equipo de la Universidad de California en San Francisco mostró que una sola interfaz cerebro-computador puede registrar actividad cerebral relacionada con distintos movimientos y utilizarla para decodificar intentos de habla y gestos al mismo tiempo. En parte de las pruebas, esas señales permitieron controlar un avatar virtual que mostraba texto y movimientos según lo que la persona intentaba hacer.
El resultado, publicado en Nature Neuroscience, no devuelve todavía una conversación completa. Pero demuestra algo importante: una misma interfaz puede empezar a recuperar más de una forma de expresión a la vez.
Hablar nunca ha sido sólo decir palabras
Imagina una conversación sin poder levantar una ceja, señalar algo con la mano, asentir o acompañar una frase con un gesto.
Todavía podríamos intercambiar información, pero algo importante desaparecería.
Nuestro cuerpo forma parte de cómo hablamos.
Ese es el problema que aborda este estudio. Las interfaces cerebro-computador ya han conseguido convertir actividad cerebral en texto, mover cursores o reconocer intentos de movimiento. Pero muchos de esos sistemas se han concentrado en una tarea por vez.
Los investigadores se hicieron una pregunta distinta:
¿Puede un solo implante distinguir que una persona está intentando hablar y gesticular al mismo tiempo?
Primero: esto no es leer pensamientos
El sistema no escucha una conversación interna ni descubre lo que alguien está pensando.
Los participantes intentan realizar acciones concretas —por ejemplo, pronunciar una frase o hacer un gesto— y el sistema aprende a reconocer patrones de actividad cerebral asociados con esos intentos.
Para registrarlos, los investigadores utilizaron electrocorticografía, o ECoG: una técnica en la que una matriz de electrodos se coloca quirúrgicamente sobre la superficie del cerebro.
Esos electrodos captan cambios eléctricos relacionados con la actividad de miles de neuronas cercanas.
No aparece una palabra escrita dentro del cerebro. Lo que aparece es una señal compleja que cambia en el tiempo.
Ahí comienza el trabajo de interpretación.
Dónde entra la inteligencia artificial
Aquí sí aparece la inteligencia artificial, pero no como protagonista ni como una herramienta generativa.
Los investigadores entrenaron redes neuronales, modelos de aprendizaje automático capaces de encontrar patrones en grandes cantidades de datos, para convertir las señales cerebrales en probabilidades.
Había un decodificador para el habla y otro para los gestos. Ambos funcionaban en paralelo.
Simplificado:
actividad cerebral → red neuronal → probabilidades → frase, gesto o reposo
Los modelos combinaban capas capaces de detectar patrones locales en la señal con otras diseñadas para analizar cómo esa señal cambia a lo largo del tiempo.
Eso importa porque intentar pronunciar una frase no produce un único impulso eléctrico. Produce una secuencia.
La inteligencia artificial no decide qué quiere decir una persona. Aprende a asociar determinadas secuencias de actividad con acciones que esa persona está intentando realizar.
El cerebro no simplemente suma las dos señales
En el estudio participaron tres personas con parálisis grave. Dos habían sufrido accidentes cerebrovasculares en el tronco encefálico y una tenía esclerosis lateral amiotrófica, o ELA.
Primero, los investigadores comprobaron que un único implante podía registrar información relacionada con distintos movimientos de la cara, la boca, las manos y otras partes del cuerpo.
La parte más importante para la comunicación simultánea se estudió después en dos participantes.
Y apareció un problema interesante.
Cuando los modelos se entrenaban solamente con intentos de hablar por separado o gesticular por separado, su desempeño empeoraba al pedir ambas cosas al mismo tiempo.
La actividad cerebral combinada no se comportaba como una suma perfectamente limpia de dos señales independientes.
Entonces los investigadores hicieron algo bastante intuitivo: incorporaron al entrenamiento ejemplos en los que habla y gesto ocurrían juntos.
El rendimiento mejoró.
En otras palabras, para reconocer mejor una situación parecida a una conversación real, el sistema también tuvo que aprender de situaciones más parecidas a una conversación real.
De una señal cerebral a un avatar
Los investigadores conectaron ambos decodificadores a un avatar virtual personalizado.
Cuando el sistema reconocía un intento de habla, mostraba la frase decodificada como texto.
Cuando reconocía un gesto, animaba el cuerpo del avatar.
Y ambas cosas podían ocurrir al mismo tiempo.
En uno de los participantes, llamado Bravo-6 en el estudio, el sistema trabajó con diez frases y diez gestos. En una prueba en tiempo real donde debía reconocer ambos simultáneamente, alcanzó aproximadamente un 70% de precisión para el habla y un 66% para los gestos. El nivel esperado por azar era cercano al 9% para cada decodificador.
Eso no significa que pudiera mantener cualquier conversación imaginable.
El vocabulario era limitado y estaba definido previamente.
La pregunta del experimento era más específica: si una sola interfaz podía manejar dos canales de expresión en paralelo.
La respuesta inicial fue que sí.
Por qué importa
Una tecnología de comunicación puede recuperar palabras y seguir dejando fuera una parte enorme de la comunicación humana.
Un “sí” acompañado de una sonrisa no comunica exactamente lo mismo que un “sí” acompañado de un gesto de duda.
Señalar, asentir, negar, saludar o mover los brazos agrega intención y contexto.
Por eso este trabajo apunta a algo mayor que aumentar la velocidad con la que una persona puede seleccionar letras en una pantalla.
Apunta a recuperar capacidad de expresión.
Para alguien que ha perdido gran parte del control de su cuerpo y de su voz, la diferencia entre transmitir únicamente texto y volver a participar en una conversación con palabras y gestos puede ser enorme.
Lo que este estudio todavía no demuestra
Aquí es donde conviene no adelantarse a la ciencia.
El estudio involucró sólo tres participantes, y las pruebas específicas de habla y gestos simultáneos se concentraron en dos.
Los vocabularios utilizados eran pequeños y definidos de antemano.
El sistema requiere además un implante cerebral quirúrgico y el montaje experimental todavía depende de infraestructura especializada.
Por eso este resultado no significa que exista hoy un dispositivo listo para que cualquier persona con parálisis pueda utilizarlo en su vida diaria.
Tampoco significa que el sistema pueda interpretar cualquier palabra, gesto o pensamiento.
Es una prueba de concepto: demuestra que el principio puede funcionar y que vale la pena seguir investigándolo.
Los autores plantean precisamente el siguiente paso: ampliar participantes, repertorios de habla y gestos, y probar sistemas capaces de funcionar de forma más flexible fuera de tareas tan controladas.
Recuperar una conversación, no sólo una función
Durante mucho tiempo, una tecnología asistiva podía plantearse como la recuperación de una función concreta: mover un cursor, seleccionar una letra, controlar una prótesis.
Este experimento mira un poco más lejos.
No pregunta solamente cómo hacer que una persona vuelva a transmitir palabras.
Pregunta cómo devolver parte de la riqueza con la que todos nos comunicamos.
Porque comunicarse no es sólo enviar información.
También es poder señalar, reaccionar, enfatizar, dudar, saludar y expresarse frente a otra persona.
Y si algún día una interfaz cerebro-computador logra devolver parte de eso a alguien que lo perdió, el avance no estará solamente en el implante.
Estará en la conversación que vuelve a ser posible.